Cron 把一次任务变成无人值守的重复动作。它的风险也在这里:错误的 profile、模型、目录或投递目标会按周期重复。真正的首次成功不是“命令创建了 job”,而是你能从 job 配置追到一次执行、一次输出、一个投递状态,并能暂停和删除它。
本课先创建一个返回 CRON-CANARY-731 的 Agent job,再用 CRON-WATCHDOG-732 验证 no-agent 的静默、告警和失败。两者都先使用 local delivery,不碰生产文件或团队消息。
本站验证范围: 2026-10-07 已在 Hermes v0.21.5 的测试 Profile 上实跑 C01–C14(只投递到 local,不发外部消息),与文档不一致处已在步骤中标出,记录见文末。
下载三份实验材料
还没做的步骤保留“待验证”。不要把预期结果复制到实际证据栏,也不要记录 provider secret、bot token 或完整环境变量。
先理解一次 fire 的证据链
schedule 到期
  → Gateway 每 60 秒 tick
  → preflight 检查配置
  → execution claimed / running
  → fresh Agent session 或 no-agent script
  → output 文件
  → delivery
  → terminal status 与下一次时间
hermes cron list 里出现 job 只证明配置存在。真正完成至少需要 execution ledger 的 terminal state、对应输出,以及 delivery 状态。
C01:锁定 profile
hermes dump
hermes cron status
将 profile 和实际 HERMES_HOME 写入运行卡。Cron 的 jobs.json、executions.db、output 与 scripts 都是 profile-local;在错误 profile 里看到“没有 job”,不能证明另一个 profile 没在运行。
Cron 由 Gateway scheduler 执行。CLI 能列出 job,不代表 Gateway 正在 tick。首轮保持 Gateway 前台运行,或明确检查同一 profile 的服务:
hermes gateway statusC02:由用户固定模型与费用边界
当前模型解析顺序是:job pin → cron.model → 全局默认。对重复任务,建议由用户显式指定 provider、model 和 reasoning effort;Agent 的 cronjob 工具不能替用户更改这些 inference pins。
先记录本轮实际可用的 provider/model,不要照抄尖括号里的示例:
provider=<你的 provider>
model=<已验证模型>
reasoning=minimal
未 pin 的 job 在创建时会记录全局模型。默认 model drift guard 检测到之后全局 provider/model 变化时,会 fail closed、跳过推理并提醒一次,直到你恢复配置或显式处理。不要为省一步关闭这个门禁。
C03:用 paused 原子创建
把下面尖括号里的示例换成 C02 的实际值:
hermes cron create "every 1h" \
  "Reply with exactly CRON-CANARY-731 and nothing else." \
  --name "cron-canary-731" \
  --deliver local \
  --provider "<provider>" \
  --model "<model>" \
  --reasoning-effort minimal \
  --paused \
  --paused-reason "Awaiting C01-C14 review"
--paused 避免创建到暂停之间的调度竞态。新 job 应显示 disabled/paused、next_run_at: null 和理由。官方文档称 pause 不挡手动 Run now;实测 v0.21.5 对暂停任务执行 cron run 会先打印”Triggered job”,紧接着提示”Job is paused/disabled; resume it before running.”,不产生任何执行记录。要手动验证,需要先 resume,跑完立即 pause。
C04:创建后先审,不先跑
hermes cron list
hermes cron doctor
逐项填入运行卡:job ID、schedule、profile、workdir、skills、provider/model/reasoning、delivery 与 paused reason。Job name 不保证唯一;后续变更优先用精确 ID。名称命中多项时当前 CLI 会拒绝并列出候选,不应该猜一个执行。
hermes cron doctor 是只读健康检查,发现任何可操作问题退出 1,健康退出 0。它会检查失败状态、投递失败、过期或缺失的 next run、丢失/越界 script、no-agent 缺 script 和不存在的 workdir。
C05–C06:手动运行并追到 terminal state
hermes cron run <job-id>
hermes cron runs <job-id> --limit 20
手动 run 是异步的。命令接受只代表请求进入调度链,不能立即填“通过”。等待最新 execution 从 claimed、running 到 completed、failed 或 unknown,再核对 active profile 下的 output。
通过证据必须同时满足:
- execution ID 与本次触发对应;
- terminal state 为 completed;
- output 精确包含
CRON-CANARY-731; - delivery 为 local,没有误投外部平台;
- job 没有意外读取 workdir、Memory 或旧聊天。
Cron run 使用 fresh Agent session。普通重复 job 不继承上一次 run 的对话;只有显式 continuity 或 context_from 才会注入旧输出。首个金丝雀不启用它们。
C07:再跑一次证明隔离
第二次手动 run 后比较两个 execution ID 和输出。它们应分别形成记录,结果相同,但不是同一 session 的续写。
执行账本会在 dispatch 前记录 attempt。进程中断且能证明原 owner 已消失时,attempt 可被标记 unknown,不会自动重跑。External side effect 仍然不是 exactly-once;真实任务必须带业务幂等键。
C08:暂停与恢复
hermes cron pause <job-id>
hermes cron list
hermes cron resume <job-id>
hermes cron list
暂停后不能自动 fire;恢复应计算未来的 next_run_at。不要用“这几分钟没看见输出”证明暂停,要看 job state 和时间字段。
恢复只是本课的生命周期验收。为了避免测试 job 按小时运行,记录完未来时间后立即再次 pause,直到 C14 删除。
C09:Preflight 为什么能省掉错误费用
当前 scheduler 会在创建 Agent machinery 前检查:provider credential、Skill 依赖,以及 delivery target 是否有配置(实测:Skill 不存在时不会进入 blocked_config,而是被跳过,见文末记录)。失败时 job 进入 blocked_config,只提醒一次,不发起 LLM 调用;健康运行后状态自动清除。
本课不要求破坏真实凭据。可以在另一个测试 profile 创建指向不存在 Skill 的 paused job,或把 C09 标为“未执行”。没有实际证据时不能写通过。
不建议设置 cron.preflight: false。那会把可提前阻止的问题推迟到执行期,并可能产生重复错误与成本。
C10–C11:把三种失败分开
| 字段 | 失败层 | 下一步 |
|---|---|---|
last_error | Agent、provider、script 或执行本身失败 | 查 runs 与对应 error output |
last_fire_error | 外部 scheduler 没把 fire 送到 Gateway | 查 Gateway/API listener 和 supervisor |
last_delivery_error | 执行成功,但消息没到目标 | 查目标身份、adapter、限流与回执 |
Delivery failure 会记录 last_status: delivery_failed,不会伪装成 ok,也不计入 Agent 的 failure streak。若只验证 local delivery,可将外部投递负例保留“未执行”;不要向陌生 chat 发送测试消息。
连续执行失败达到阈值时会出现 review nudge。相同错误还会形成 incident:
hermes cron incidents
hermes cron incidents --state alerted
hermes cron incidents ack <incident-id>
ack 只停止该错误签名继续提醒,不修复 job、不清空 runs,也不重置 failure streak。
C12:验证 no-agent 的三种结果
将下载脚本保存到当前 profile:
<HERMES_HOME>/scripts/cron-canary.sh同目录建立 cron-canary.mode,内容只能是 silent、alert 或 fail。创建 paused job:
hermes cron create "every 1h" \
  --no-agent \
  --script cron-canary.sh \
  --deliver local \
  --name "cron-watchdog-732" \
  --paused \
  --paused-reason "Awaiting watchdog review"
分别修改 mode 文件并手动 run:
| mode | 预期 |
|---|---|
silent | stdout 为空,本次 tick 静默,但 runs 留证据 |
alert | stdout 原样投递 CRON-WATCHDOG-732 |
fail | exit 23,产生错误状态和告警 |
no-agent 不调用模型,也没有 provider fallback。脚本必须解析到 $HERMES_HOME/scripts/ 内;越界路径会被拒绝。Hermes-managed secrets 不会继承给该 subprocess。静默没有消息不等于没执行,必须从 runs ledger 核对。
C13:做一次 fleet health 检查
hermes cron doctor
hermes cron list
确保测试中的 deliberate failure 已解释、两个 job 都处于 paused,并且没有丢失 workdir、script 或 next-run 异常。真实 recurring job 若持续失败,应先 pause 再处理,不让后台错误按频率扩大。
C14:完整移除
hermes cron pause <agent-job-id>
hermes cron pause <watchdog-job-id>
hermes cron remove <agent-job-id>
hermes cron remove <watchdog-job-id>
hermes cron list
hermes cron doctor
列表不再出现两个 ID,且没有未来 trigger,才算删除完成。Output 与 execution history 是否保留,应按你的审计策略记录;不要用粗暴删除整个 profile 来代替单 job 生命周期验收。
六类真实任务怎样迁移
完成金丝雀后,只把一个真实任务迁入:
| 场景 | 先选模式 | 第一阶段产物 | 不自动做什么 |
|---|---|---|---|
| 每周内容缺口 | Agent + 已审查 Skill | local Markdown 报告 | 不改正文、不发布 |
| 每日构建检查 | no-agent 或 script gate | 只在失败时告警 | 不自动修代码 |
| 依赖更新提醒 | Agent | 需关注/可忽略/待确认 | 不自动升级 |
| Memory 清理 | Agent | 删除建议 | 不直接删 Memory |
| 固定格式周报 | Skill-backed Agent | 草稿或个人入口 | 不群发 |
| 服务心跳 | no-agent | 异常 stdout | 不重启生产服务 |
每个真实 job 都重新走 C01–C14。高频任务优先用 no-agent 或 wakeAgent:false 的 pre-run gate,避免“没有变化”也支付一次模型调用。
Workdir、Skills 与 Delivery 的上线规则
--workdir 必须是存在的绝对目录。设置后,该目录的 AGENTS.md、CLAUDE.md、.cursorrules 会进入系统上下文,文件和终端工具也以此为工作目录。它不是一个装饰字段,应当作为权限输入审查。
Skill-backed job 只加载已经通过固定回归的 Skills。多个 Skill 按顺序加载,不能把临时脚本直接放进长期 schedule。
CLI 创建的 job 默认 local,消息入口创建通常默认 origin。切换到 Telegram 等目标前,先完成 Gateway 的授权与 delivery 负例。Agent 的最终回复会由 Cron 自动投递;不要在 prompt 里再让 Agent 调发送工具,否则可能重复发送。
本站实测记录(2026-10-07,Hermes v0.21.5)
环境:macOS 26.4(Apple Silicon),Hermes v0.21.5(2026.9.24),模型 glm-5.3-flash(zai),测试 Profile aclab 及临时 Profile,均不连接消息平台;你的 default Profile 与正在运行的 Gateway 未改动。 Agent 任务显式指定 --provider zai --model glm-5.3-flash --reasoning-effort minimal,投递只用 local。
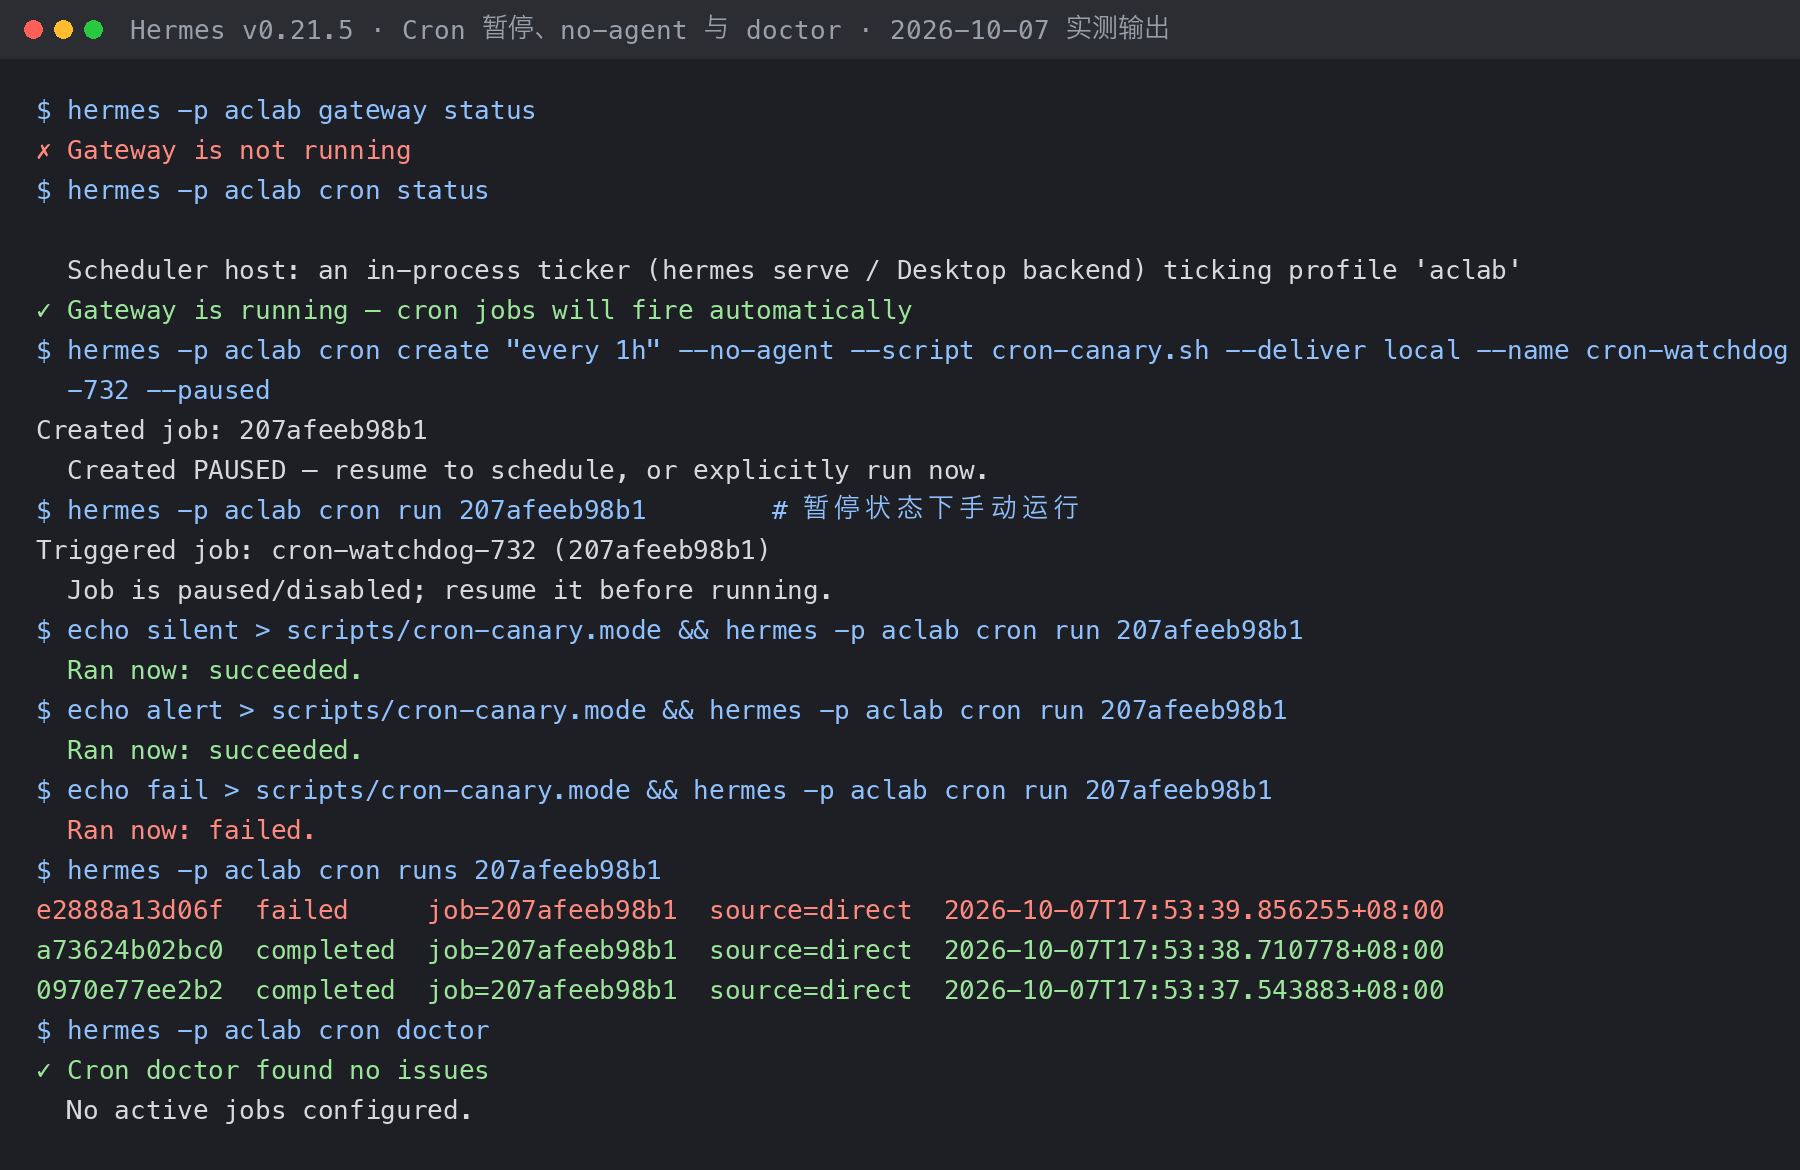
| 步骤 | 实测结果 |
|---|---|
| C01 | gateway status 显示 ✗ 未运行,cron status 却显示”Scheduler host: an in-process ticker … ticking profile ‘aclab’”、“cron jobs will fire automatically” |
| C03–C04 | --paused 创建成功,Next run 为 None;cron doctor 退出码 0 |
| 暂停时手动 run | ”Job is paused/disabled; resume it before running.”,无执行记录 |
| C05–C07 | resume 后手动 run 同步返回”Ran now: succeeded”;两次 execution ID 不同,都是 completed,输出文件都精确为 CRON-CANARY-731 |
| C08 | pause 后 cron list 仍显示一个 Next run 时间(教程说应为空),以 [paused] 状态为准 |
| C12 no-agent | silent → completed,输出标记”silent (empty output)“;alert → 原样输出 CRON-WATCHDOG-732;fail → failed,记录”Script exited with code 23”和 stderr,并产生 1 条 incident |
| C13 doctor | 任务带着 code 23 错误,doctor 仍报”no issues / No active jobs configured”,退出码 0 |
| C09 preflight | 引用不存在的 Skill no-such-skill-739:创建无警告,运行结果 ok |
| C14 | 三个任务 remove 后列表为空,输出目录随之清空;incident 需要单独 cron incidents ack |
三个与文档不一致、上线前必须知道的点:
- **“Gateway 未运行”不等于 Cron 不会跑。**在 v0.21.5 的”一台机器一个 Gateway”模式下,default 的 Gateway(或桌面版后端)会替所有 Profile 计时。
-p <名称> gateway status只说明这个 Profile 没有独立 Gateway。判断依据要看cron status里的 Scheduler host 和心跳。 - **doctor 看不见暂停的任务。**失败后先 pause 是正确做法,但之后 doctor 会报”没有问题”。暂停任务的错误要用
cron list和cron incidents查。 - **缺失的 Skill 会被静默跳过。**运行输出里可以看到系统给模型加的提示:“skill(s)… could not be found and were skipped… Start your response with a brief notice”。但任务指令要求”只回复固定文本”,模型就省略了这句提示,结果记为 ok。所以给 Cron 绑定 Skill 后,要先
skills list确认名称存在,不能指望 preflight 拦住。
完成检查
- 你用精确 profile 和 job ID 追踪了配置、execution、output 与 delivery。
- Agent job 由用户固定模型和 reasoning,并以 paused 状态创建。
- 两次手动 run 都追到 terminal state,没有把异步接受当完成。
- 你能区分
last_error、last_fire_error与last_delivery_error。 - no-agent 的 silent、alert、fail 三种模式都有 runs 证据且没有模型调用。
- 两个测试 job 均已 pause、remove,并用 list 与 doctor 复查。
需要把 Cron 输出送到消息平台时,先完成 Messaging Gateway 运维验收。需要长期复用固定动作时,先完成 Hermes Skills 回归实验。